Foram encontradas 5.237 questões.
Durante o treinamento de uma rede neural artificial para classificação de imagens, foi observado o comportamento descrito pelo gráfico abaixo, que mostra a evolução do erro conforme o número de iterações.
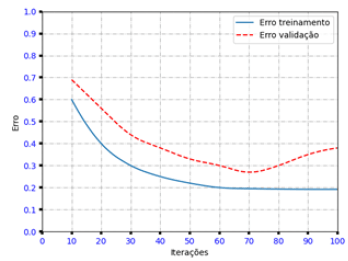
O classificador em questão foi treinado em um conjunto de dados particionado (holdout) em 60%/30%/10% (treinamento/validação/teste). Entretanto, os especialistas envolvidos consideraram o modelo obtido insatisfatório após analisarem o gráfico.
Considerando essas informações, duas técnicas que poderiam ser utilizadas para contornar o problema encontrado são:
Provas

(1) Armazenamento primário
(2) Armazenamento secundário ou on-line
(3) Armazenamento terciário ou off-line
( ) Memória Cache
( ) Disco Óptico
( ) Memória Principal
( ) Disco Magnético
( ) Memória Flash
( ) Fita Magnética
A sequência correta de preenchimento dos parênteses, de cima para baixo, é
Provas
Disciplina: TI - Ciência de Dados e BI
Banca: CESPE / CEBRASPE
Orgão: PGE-RJ
Com relação a data warehouse e data mining, julgue o item.
Um data warehouse usa técnicas estatísticas e de aprendizagem automática para, em uma coleção de dados orientada ao assunto e não volátil, extrair e identificar informações úteis com objetivos de apoiar a tomada de decisão.
Provas
Disciplina: TI - Ciência de Dados e BI
Banca: CESPE / CEBRASPE
Orgão: PGE-RJ
Com relação a data warehouse e data mining, julgue o item.
No processo de data warehousing, ETL transforma os dados oriundos de staging área, utilizando repositório de dados de sistemas de processamento de transações online (OLTP) como armazenamento temporário para inserir em data warehouse.
Provas
Natasha, uma cientista de dados, está trabalhando com um conjunto de dados sobre carros para fazer um modelo preditivo para uma companhia de seguros. A primeira versão do modelo utiliza apenas informações básicas sobre os carros: a marca e a cor.
Como esses dados são categóricos, Natasha faz um pré-processamento usando a biblioteca scikit-learn. Em um ambiente interativo, ela executa os comandos a seguir.
>>> from sklearn.preprocessing import OneHotEncoder
>>> enc = OneHotEncoder()
>>> X = [['Toyota', 'vermelho'], ['Toyota',
'verde'], ['BMW', 'vermelho']]
>>> enc.fit(X)
>>> enc.get_feature_names()
array(['x0_BMW', 'x0_Toyota', 'x1_verde', 'x1_vermelho'], dtype=object)
>>> X_prime = enc.transform(X).toarray()
>>> X_prime
array([[0., 1., 0., 1.], [0., 1., 1., 0.], [1., 0., 0., 1.]])
Para contar o número de carros da marca Toyota no conjunto de dados, obtendo corretamente o resultado 2, Natasha pode usar a seguinte linha de código:
Provas
Um analista do TCU recebe o conjunto de dados com covariáveis e a classe a que cada amostra pertence na tabela a seguir.
|
X1 |
X2 |
Classe |
| 0 | 1 | A |
| 0 | 2 | B |
| 1 | 0 | A |
| 1 | -1 | B |
| 2 | 2 | B |
| 1 | 2 | A |
| -1 | 1 | B |
| 2 | 3 | A |
Esse analista gostaria de prever a classe dos pontos (1,1), (0,0) e (-1,2) usando o algoritmo de k-vizinhos mais próximos com k=3 e usando a distância euclidiana usual.
Suas classes previstas são, respectivamente:
Provas
Seja uma rede neural com camada de entrada com dimensão dois que recebe dados (x1, x2). Essa rede aplica pesos w1 em x1, w2 em x2 e adiciona um viés w0. A função de ativação é dada pela função sinal s(z) = +1, se z \( \ge \) 0, e s(z) = -1, se z \( < \) 0. Essa rede não tem nenhuma camada oculta e será utilizada para classificar observações em y=+1 ou y=-1.
Para pesos w1 = 2, w2 = 3 e viés w0 = 1, a região de classificação é uma reta que passa nos pontos:
Provas
Um analista do TCU gostaria de aplicar um modelo de Latent Dirichlet Allocation (LDA) em um conjunto de textos.
A alternativa que melhor descreve o resultado do modelo é:
Provas
A tabela presente no código em R abaixo apresenta a quantidade de processos analisados por três analistas (denotados por A1, A2 e A3) em diferentes anos.
dados = tibble::tibble(Analista=c(“A1”, “A1”, “A1”, “A2”,
“A2”, “A3”, “A3”, “A3”),
Ano=c(2018,2019,2020,2019,2020,2018,2019,2020),
Processos=c(10,15,20,25,20,8,7,12))
Um programador roda o código abaixo em R.
tidyr::pivot_wider(data=dados, names_from=”Analista”,
values_from=”Processos”)
Os valores esperados na primeira linha do objeto resultante do comando acima são:
Provas
Disciplina: TI - Ciência de Dados e BI
Banca: CESPE / CEBRASPE
Orgão: PGE-RJ
Julgue o próximo item, a respeito de business intelligence (BI).
Data warehouse contém grande variedade de dados que apresentam uma imagem coerente das condições da empresa em um determinado ponto no tempo; por conta dessas características, não pode ser utilizado como repositório de dados em uma arquitetura de BI.
Provas
Caderno Container