Foram encontradas 5.237 questões.
Sobre as técnicas de integração e ingestão de dados ETL (Extract, Transform, Load) e ELT (Extract, Load, Transform), assinale a opção incorreta.
Provas

Seja o conjunto de dados X apresentado a seguir, em que os atributos “P” e “Q” são preditores, e o atributo “Classe” é o atributo-alvo:
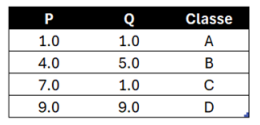
Queremos classificar uma nova amostra x=(5.0, 5.0) utilizando o algoritmo clássico dos k vizinhos mais próximos (k-NN), utilizando a distância euclidiana para a determinação de vizinhanças. Com base nesse algoritmo, e considerando os valores aproximados de √2 ≈ 1,414 e √3 ≈ 2,236, o k-NN retorna como categoria de x
Provas
A validação cruzada é uma importante técnica em aprendizado de máquina, usada para obter uma estimativa mais robusta do erro de generalização. Dessa forma, ela contribui para a construção de modelos mais confiáveis, permitindo uma avaliação mais precisa de sua capacidade preditiva em diferentes cenários.
Uma das características da validação cruzada com k conjuntos é que esse método
Provas
Em arquiteturas modernas de Data Warehousing, o processo de ETL é fundamental para preparar os dados de forma eficiente para a tomada de decisões estratégicas.
Ele é como uma ponte entre os sistemas e o Data Warehouse. Nesse contexto, o principal objetivo do processo de ETL em uma solução de Data Warehousing é
Provas
Um conjunto de dados foi particionado em dois subconjuntos, sendo um de treinamento e outro de testagem, ambos utilizados exclusivamente para serem usados em seus objetivos originais (dados de treino para treinamento, e de teste para testagem).
Em relação ao ajuste e validação de modelos em aprendizado de máquina, um modelo sofre overfitting quando
Provas
A Inteligência Artificial (IA) é uma área da ciência da computação que visa desenvolver sistemas capazes de realizar tarefas que normalmente exigiriam inteligência humana.
O conceito que está mais diretamente relacionado ao desenvolvimento de sistemas que aprendem com os dados e melhoram seu desempenho ao longo do tempo é o de
Provas
Seja o código em R a seguir:
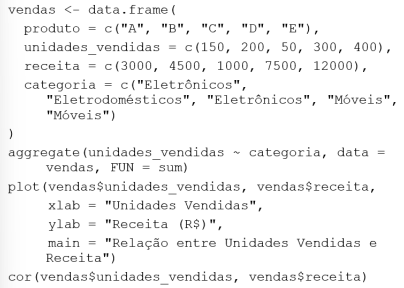
Analisando o código apresentado, sem a necessidade de executálo, é correto deduzir que
Provas
Considere o seguinte cenário: Uma empresa de telecomunicações está analisando os dados de uso de seus clientes, como frequência de chamadas, uso de dados móveis e envio de mensagens. Ela quer identificar grupos de clientes com comportamentos semelhantes para oferecer promoções personalizadas.
Em uma escolha por uma solução de aprendizado de máquina, o cientista de dados deve observar que, se o aprendizado for
Provas
O algoritmo de redução de dimensionalidade conhecido como Análise de Componentes Principais (PCA – Principal Component Analysis) possui características importantes.
Dada a escolha de um número k de componentes principais e um conjunto de dados X com cinco variáveis A, B, C, D e E, o PCA
Provas
Algoritmos de agrupamento podem ser classificados em diferentes categorias. Um algoritmo de agrupamento amplamente utilizado em aprendizado de máquina e mineração de dados é conhecido como K-Means.
O K-Means, em sua versão original, é classificado como um tipo de algoritmo
Provas
Caderno Container