Foram encontradas 5.237 questões.
Uma organização está implementando práticas de gerenciamento de dados para aprimorar a qualidade e a integridade dos dados em seus sistemas.
Nesse contexto, qual conceito do DAMA DMBoK destaca a importância de garantir que os dados sejam precisos e atendam aos requisitos de qualidade?
Provas

Admita que a área de desenvolvimento de softwares do Ipea está confeccionando um aplicativo responsivo de Machine Learning (ML) usando o Bootstrap, de modo a melhorar a apresentação das planilhas que mostram os vínculos de trabalho das pessoas do setor público. Qual algoritmo de conjunto deve ser utilizado para incrementar a estabilidade desse aplicativo de ML?
Provas
Considere uma sociedade empresária hipotética, associada ao Ipea, que pratica a governança de dados para Tecnologia da Informação, segundo os critérios estabelecidos por esse Instituto, e que está definindo o escopo de dados da sua estrutura de governança. Ambas organizações vão compartilhar os dados de igual para igual, por meio de uma gerência baseada em um único registro para cada pessoa, local e objeto, usado tanto pela sociedade empresária quanto pelo Ipea. Está sendo confeccionado um modelo de processo empresarial que garanta que os dados compartilhados sejam consistentes e precisos.
Nesse caso, é necessário aplicar o seguinte processo:
Provas
No aprendizado não supervisionado, os dados de treinamento não têm rótulos. O objetivo é agrupar instâncias semelhantes em clusters. Nesse contexto, suponha que se deseja executar um algoritmo de agrupamento para tentar detectar grupos de visitantes semelhantes em um blog. Em nenhum momento é informado ao algoritmo a que grupo um visitante pertence, mas ele encontra essas conexões sem ajuda. Por exemplo, o algoritmo pode notar que 40% dos visitantes são homens que adoram histórias em quadrinhos e, geralmente, leem o blog à noite, enquanto 20% são jovens amantes de ficção científica que visitam o blog durante os fins de semana, e assim por diante. Deseja-se, nesse caso, usar um algoritmo de agrupamento hierárquico para subdividir cada grupo em grupos menores, o que pode ajudar a direcionar as postagens do blog para cada grupo específico.
Nesse cenário, qual é o algoritmo mais apropriado para fazer o agrupamento desejado?
Provas
- Inteligência ArtificialMachine LearningAlgoritmosÁrvores de Decisão
- ProgramaçãoPythonScikit-learn (Sklearn)
As árvores de decisão são um modelo de aprendizado de máquina que opera por meio da construção de uma estrutura em forma de árvore para tomar decisões e que oferece uma compreensão clara da lógica de decisão e da hierarquia de características que contribuem para as predições finais. Elas são versáteis e podem ser usadas tanto para tarefas de classificação quanto para as de regressão.
Nesse contexto, considere a construção de uma árvore de regressão usando a classe DecisionTreeRegressor do Scikit-Learn e seu treinamento em um conjunto de dados quadrático com max_depth=2, conforme mostrado a seguir:
from sklearn.tree import DecisionTreeRegressor
tree_reg = DecisionTreeRegressor(max_depth=2)
tree_reg.fit(X, y)
A árvore resultante é representada na Figura a seguir.
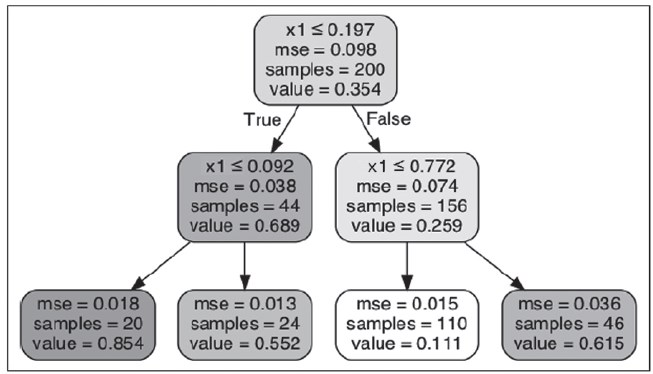
GÉRON, A. Hands-on machine learning with Scikit-Learn, Keras, and TensorFlow: Concepts, Tools, and Techniques
to Build Intelligent Systems. 2 ed. Sebastopol, CA: O’Reilly Media, Inc.: 2019, p. 183.
Considerando-se o cenário apresentado e que se deseja fazer uma predição para uma nova instância, com x1 = 0.6, qual será o valor predito?
Provas
Em uma nota técnica do Ipea sobre emprego público nos governos subnacionais brasileiros, no ano de 2016, aparece menção sobre o fato de as bases utilizadas possuirem outliers, ou valores atípicos.
A construção de um modelo preditivo a partir dos dados dessas bases, usando árvores aleatórias, Random Forests,
Provas
Alguns trabalhos publicados como notas técnicas pelo Ipea se utilizam do método de classificação denominado de Bayes Ingênuo.
No contexto do classificador Bayesiano Ingênuo, Naive Bayes, a ingenuidade do modelo é caracterizada pela(o)
Provas
Um cientista de dados está utilizando máquinas de vetor de suporte (SVM) em um projeto de classificação, pois deseja evitar o overfitting do modelo aos dados de treinamento.
Qual das seguintes técnicas auxilia a prevenir o overfitting em SVM?
Provas
Em um projeto de classificação de textos, um modelo de machine learning foi aplicado em um conjunto de teste e apresentou os seguintes resultados: uma precisão de 80% e uma revocação de 70%.
Com base nessas informações e considerando-se apenas a parte inteira da porcentagem, qual é o F1 Score desse modelo?
Provas
Um pesquisador possui um conjunto de dados consistindo em características diversas, features, e suas respectivas classificações, labels. Ele deseja dividir esse conjunto de dados em conjuntos distintos, para treinamento e para teste, com o objetivo de validar a eficácia de um modelo de aprendizado de máquina. Nesse contexto, qual função do SciKit-learn ele deve utilizar para realizar essa divisão de maneira eficiente e adequada?
Provas
Caderno Container